Concepto
Qué es RAG y cómo usarlo en tu empresa
RAG conecta un modelo de lenguaje con los documentos de tu empresa para que responda con ellos y cite la fuente. Cómo funciona, cuándo conviene frente a poner todo en la instrucción o hacer fine-tuning, y cómo probarlo con diez o más preguntas.
Revisada el
RAG (Retrieval-Augmented Generation, generación aumentada por recuperación) es una técnica que le entrega a un modelo de lenguaje el material de consulta correcto justo antes de responder. En una empresa, un asistente puede contestar con tus manuales, políticas y protocolos, y citar de dónde sacó cada dato, en lugar de inventar información o de reentrenar el modelo cada vez que un documento cambia.
Pensemos en la aseguradora ficticia Quillaval Seguros. Si a un asistente general le preguntas a quién avisar y en qué plazo ante una filtración de datos, no conoce el protocolo interno: puede reconocer que no sabe o inventar algo que suena razonable. Si se apoya en una página antigua, puede orientar mal aunque el protocolo vigente diga otra cosa.
Respuesta corta: ¿cuándo conviene usar RAG?
- Usa RAG cuando el conocimiento vive en tus documentos, cambia seguido, depende de permisos o necesita citar documento y sección.
- Con pocos documentos, parte simple: ponlos completos en la instrucción (el texto que le das al modelo antes de que responda) o usa una herramienta lista.
- Exige citas y un mensaje claro cuando no hay respaldo.
- Mide con diez o más preguntas de respuesta conocida antes de ampliar.
¿Cómo funciona RAG?
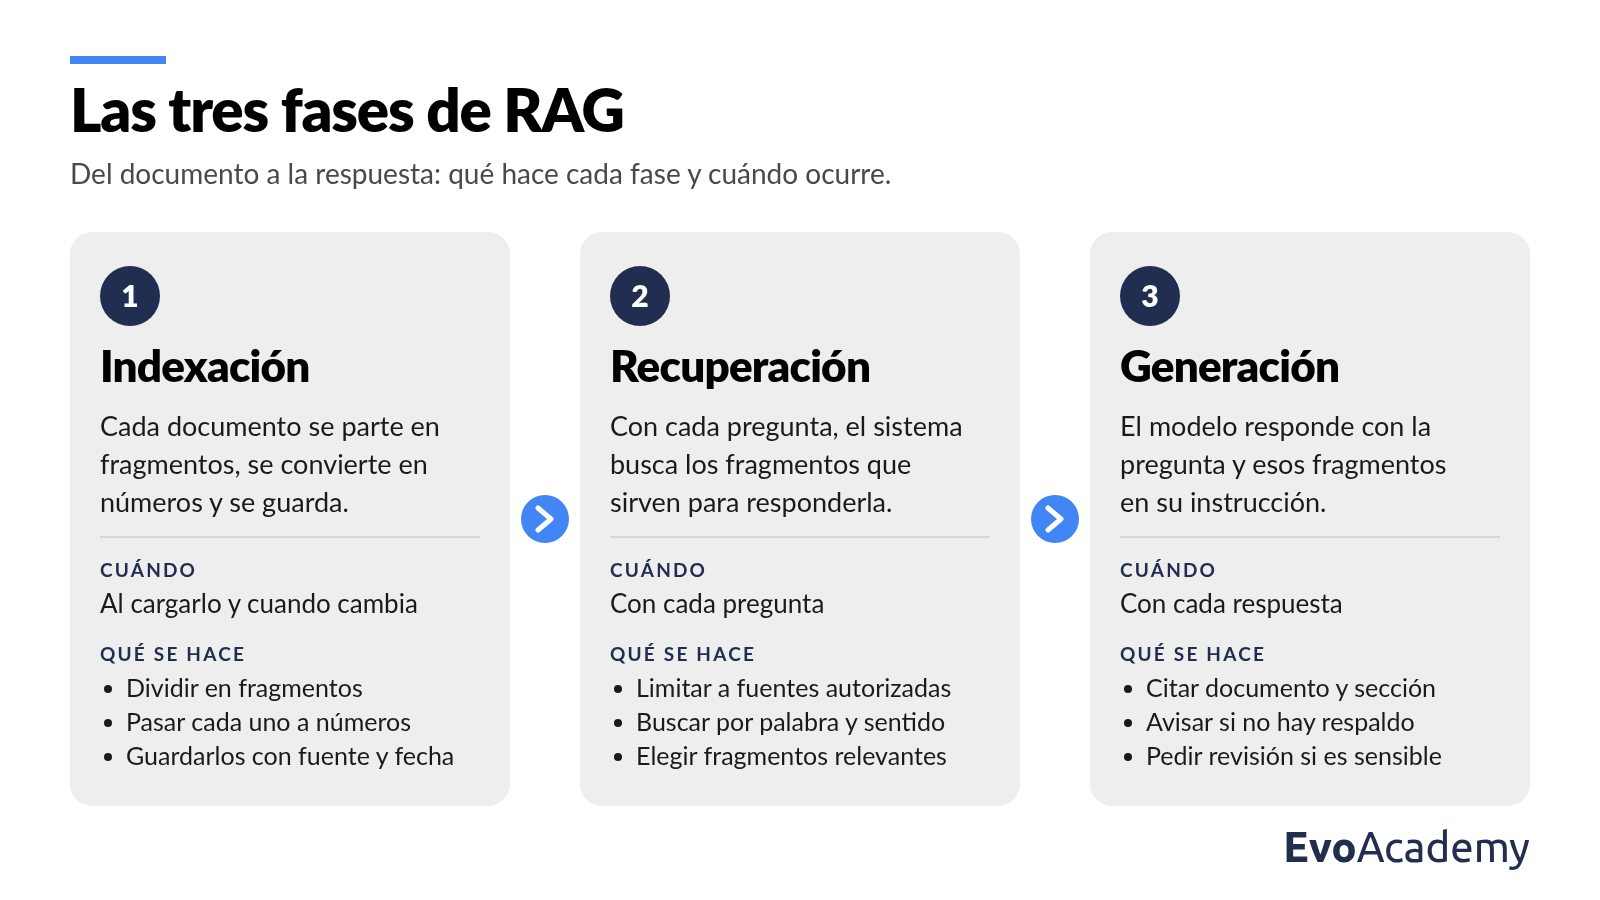
La indexación se hace al incorporar un documento y se repite cuando cambia: se parte el texto en fragmentos (chunks), se convierte a números (embeddings) y se guarda en una base vectorial, una base de datos pensada para buscar textos por similitud de significado, con la fuente, la fecha y el permiso. La recuperación, en cambio, ocurre con cada pregunta y trae los fragmentos relevantes. Luego, en la generación, el modelo responde con la pregunta y esos fragmentos en su instrucción.
Indexación
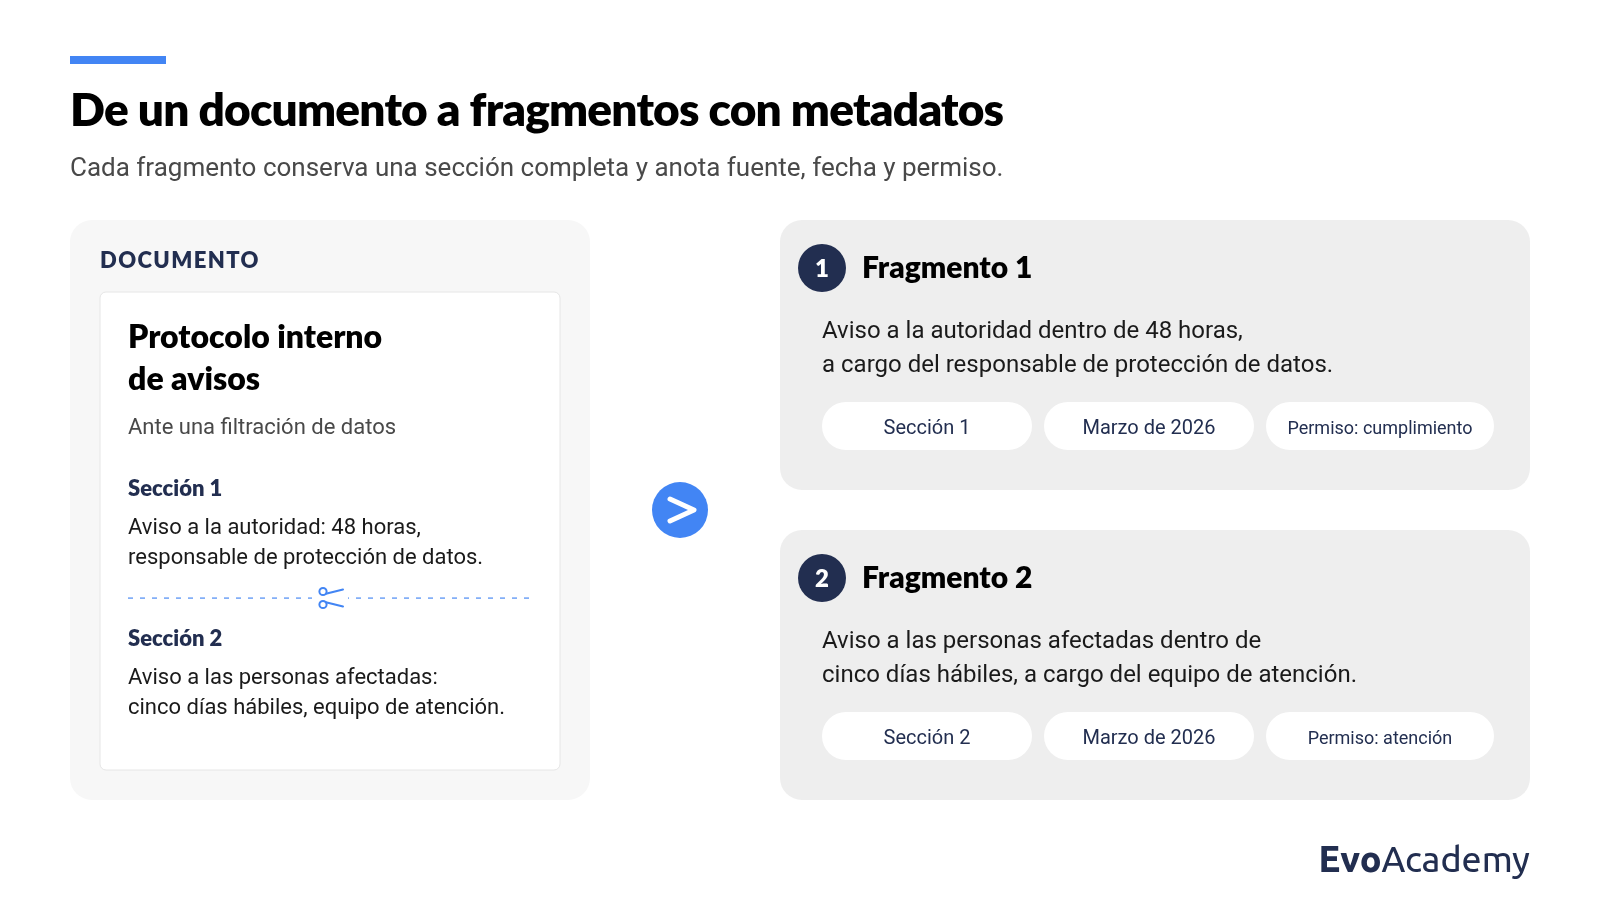
Se parte un documento largo para que una pregunta traiga el dato que necesita, no todo el relato. Un fragmento suele cubrir unos pocos párrafos: lo bastante corto para aislar un tema y lo bastante largo para conservar el sentido. A menudo se deja un solapamiento (las últimas líneas de un fragmento se repiten al inicio del siguiente), para que una oración del borde no quede partida. Procura que el corte no parta una regla: idealmente cada fragmento conserva una sección o un artículo completo. La indexación se vuelve a correr cuando el documento cambia, para que la versión vigente reemplace a la anterior en la base.
En la aseguradora ficticia Quillaval Seguros, un protocolo interno de avisos ante una filtración de datos queda, en este ejemplo, en dos fragmentos. El primero conserva la sección del aviso a la autoridad (48 horas, a cargo del responsable de protección de datos). El segundo conserva la del aviso a las personas afectadas (cinco días hábiles, a cargo del equipo de atención). Junto a cada texto se guardan la fuente, la sección, la fecha y quién puede consultarlo, para citar después y para filtrar por permiso.
Los embeddings convierten un texto en números que capturan su significado. Para verlo, usamos vectores simulados en dos dimensiones (los embeddings reales tienen cientos o miles de dimensiones): cada palabra se representa con un par de números, “rey” (0,92; 0,18), “reina” (0,88; 0,30) y “manzana” (0,10; 0,95). La similitud de coseno, que va de -1 a 1 y mide cuán parecida es la dirección de dos vectores, queda así:
| Comparación | Similitud de coseno |
|---|---|
| “rey” y “reina” | 0,991 |
| “rey” y “manzana” | 0,294 |
| “reina” y “manzana” | 0,420 |
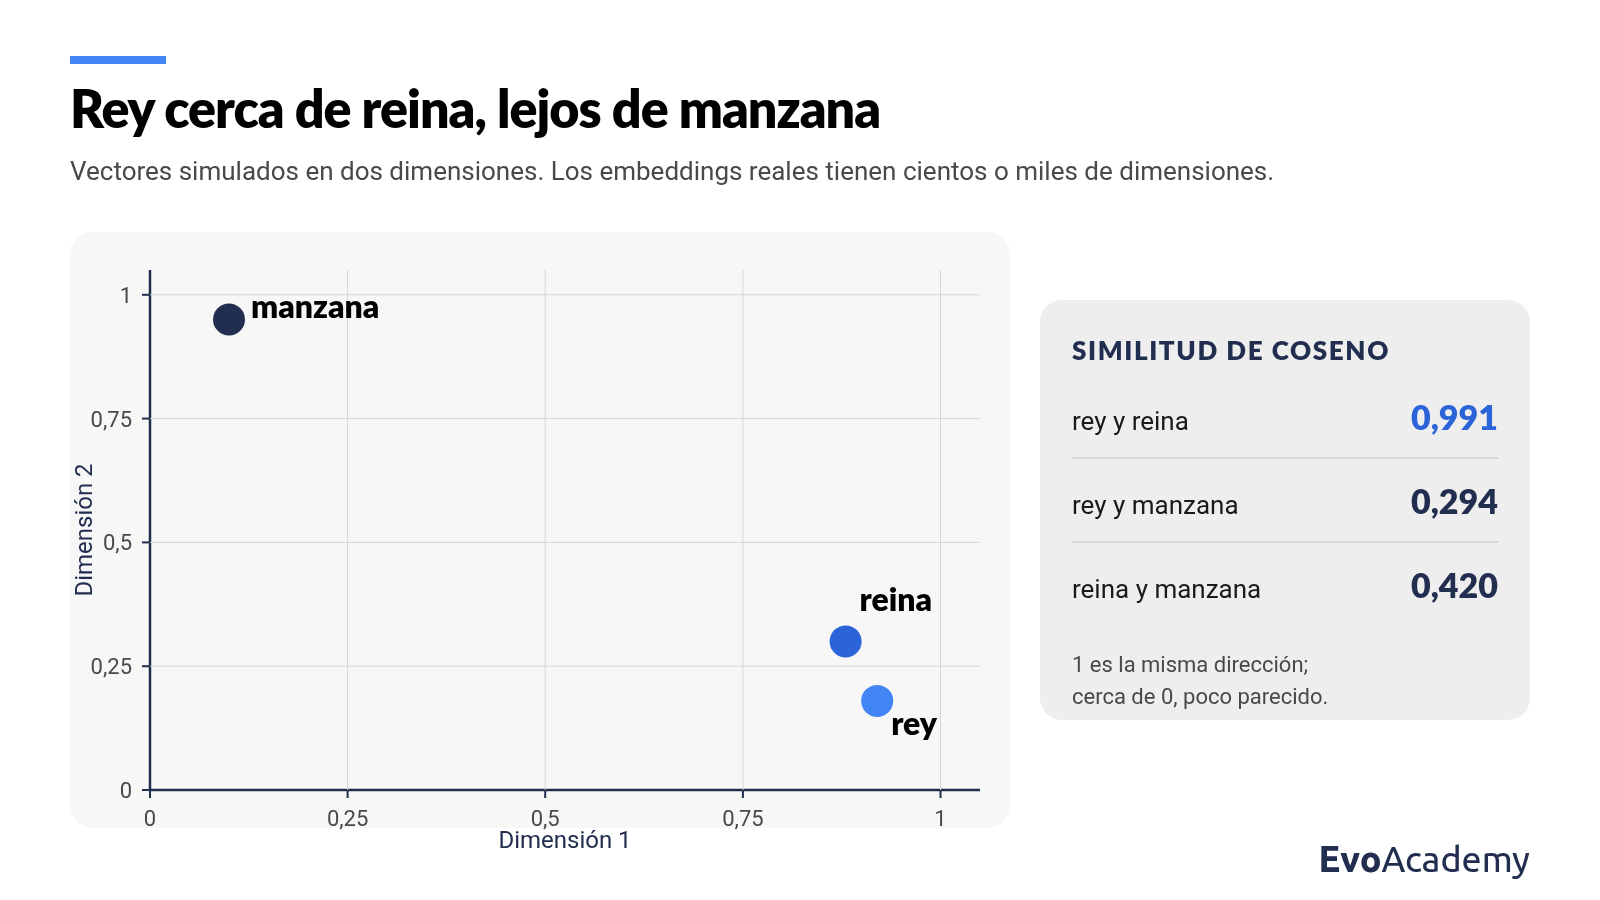
“Rey” y “reina” apuntan casi en la misma dirección; “manzana” queda aparte. Por eso el sistema puede encontrar un párrafo sobre vacaciones aunque la pregunta diga días libres. Luego esos números se guardan en la base vectorial.
Recuperación
Con cada pregunta, el sistema la convierte en un vector con el mismo modelo de embeddings que usó con los fragmentos, y por eso ambos se pueden comparar. Luego busca en la base los vecinos más cercanos: los k fragmentos cuya dirección más se parece a la de la pregunta. k es cuántos candidatos pides; en implementaciones reales suelen ser varios, no uno solo. Entregar solo los fragmentos relevantes, en vez del documento entero, suele ayudar a que el modelo responda con más precisión y con menos distracción.
Buscar por vectores supone que lo más parecido es lo más relevante. Si preguntas “¿Dónde está el perro de Isabel?”, comparamos esa pregunta con tres fragmentos, otra vez con vectores simulados:
| Fragmento | Similitud de coseno con la pregunta |
|---|---|
| El perro de Isabel está en el parque | 0,997 |
| Isabel sacó a pasear a su mascota | 0,886 |
| Isabel compró manzanas en el mercado | 0,342 |
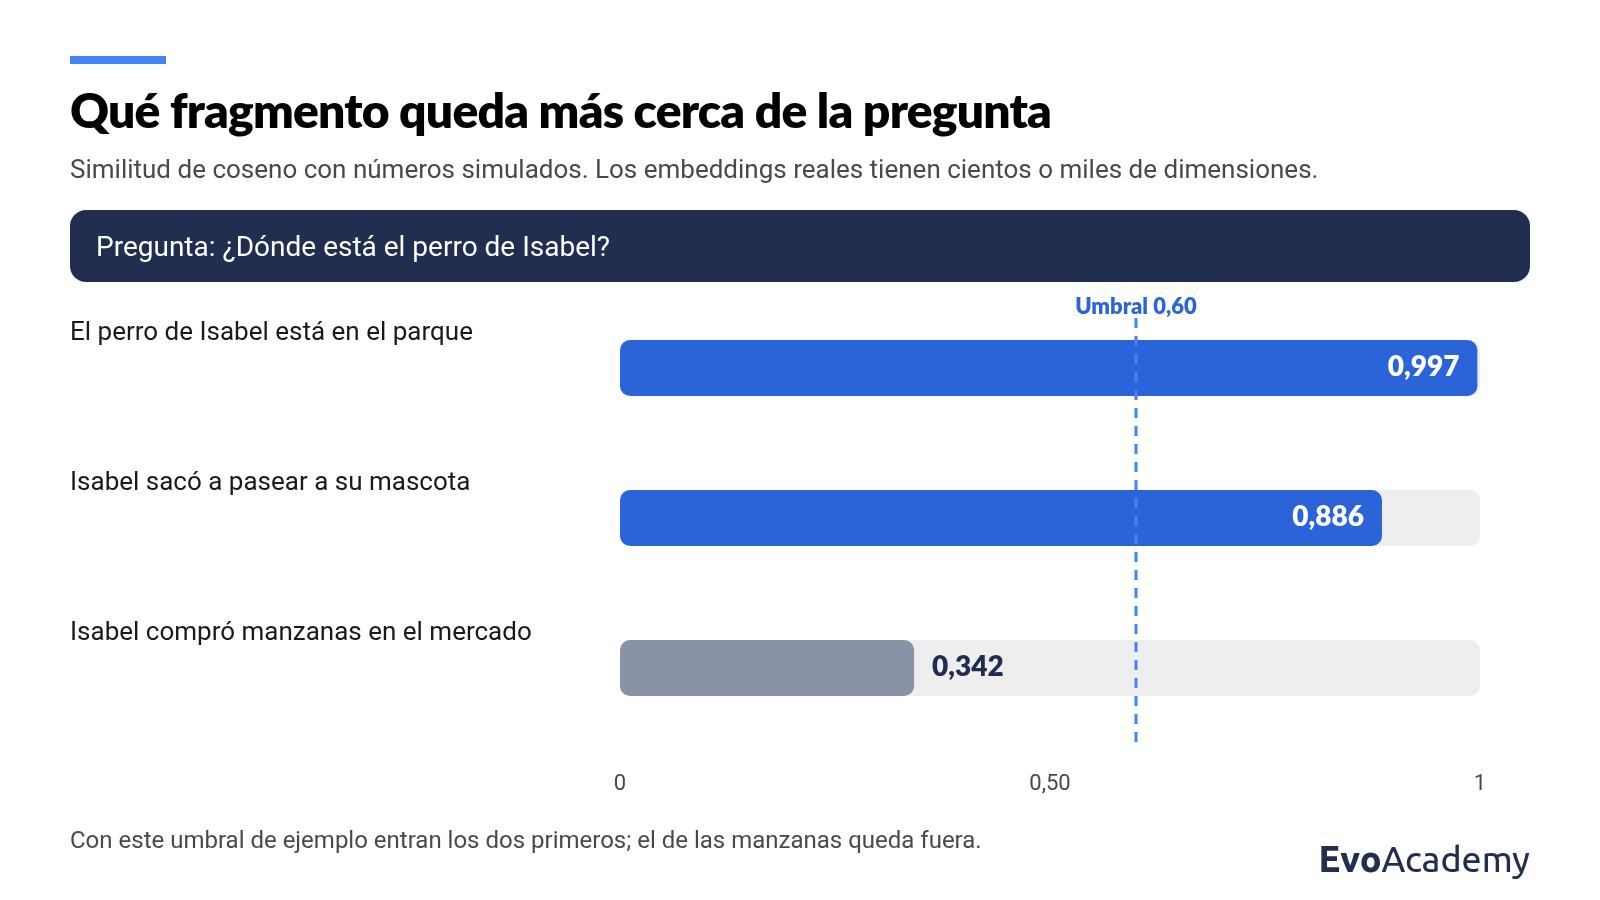
El fragmento del parque responde la pregunta, mientras que el del paseo habla de Isabel y su mascota, pero no dice dónde está. El de las manzanas, aunque comparte el nombre, queda por debajo de un umbral de ejemplo de 0,60 sobre la similitud de coseno: es un corte numérico sobre esa puntuación, no un juicio aparte. Si ninguno supera el umbral, el sistema responde que no encontró respaldo. En muchos sistemas, después de esa primera lista entra un re-ranker: un modelo que lee la pregunta junto con cada candidato y asigna un puntaje propio para reordenar o filtrar otra vez.
Antes de buscar, a veces se reescribe la pregunta para acercarla a cómo están redactados los documentos, o se le quita lo que no ayuda a encontrarlos: “qué hacemos si se escapan los datos de los clientes” puede pasar a “filtración de datos: a quién avisar y en qué plazo”. Muchos sistemas combinan esas palabras clave con la búsqueda por vectores en una búsqueda híbrida, porque el número de un protocolo y su sección aparecen mejor por texto exacto que por similitud sola.
El mismo tipo de ranking aparece en el caso ilustrativo del protocolo de avisos: si solo se entrega el fragmento más cercano, el asistente puede quedarse con un aviso y perder el otro.
Generación
Con la pregunta y los fragmentos recuperados se arma una instrucción para el modelo (pregunta, cada fragmento con su fuente y las reglas de citar documento y sección, o de responder “No encontré respaldo” si ninguno sirve). En este ejemplo simulado, quien pregunta tiene permiso para consultar las dos secciones del protocolo de avisos, y la instrucción queda así:
Instrucción
Responde solo con los fragmentos entregados. Cita el documento y la sección. Si ninguno responde, di: “No encontré respaldo.”Pregunta
Si ocurre una filtración de datos, ¿a quién debemos avisar y en qué plazo?Fragmento 1
Protocolo interno de avisos, sección “Aviso a la autoridad”, marzo de 2026. Avisa a la autoridad dentro de 48 horas, a cargo del responsable de protección de datos.Fragmento 2
Protocolo interno de avisos, sección “Aviso a las personas afectadas”, marzo de 2026. Avisa a las personas afectadas dentro de cinco días hábiles, a cargo del equipo de atención.
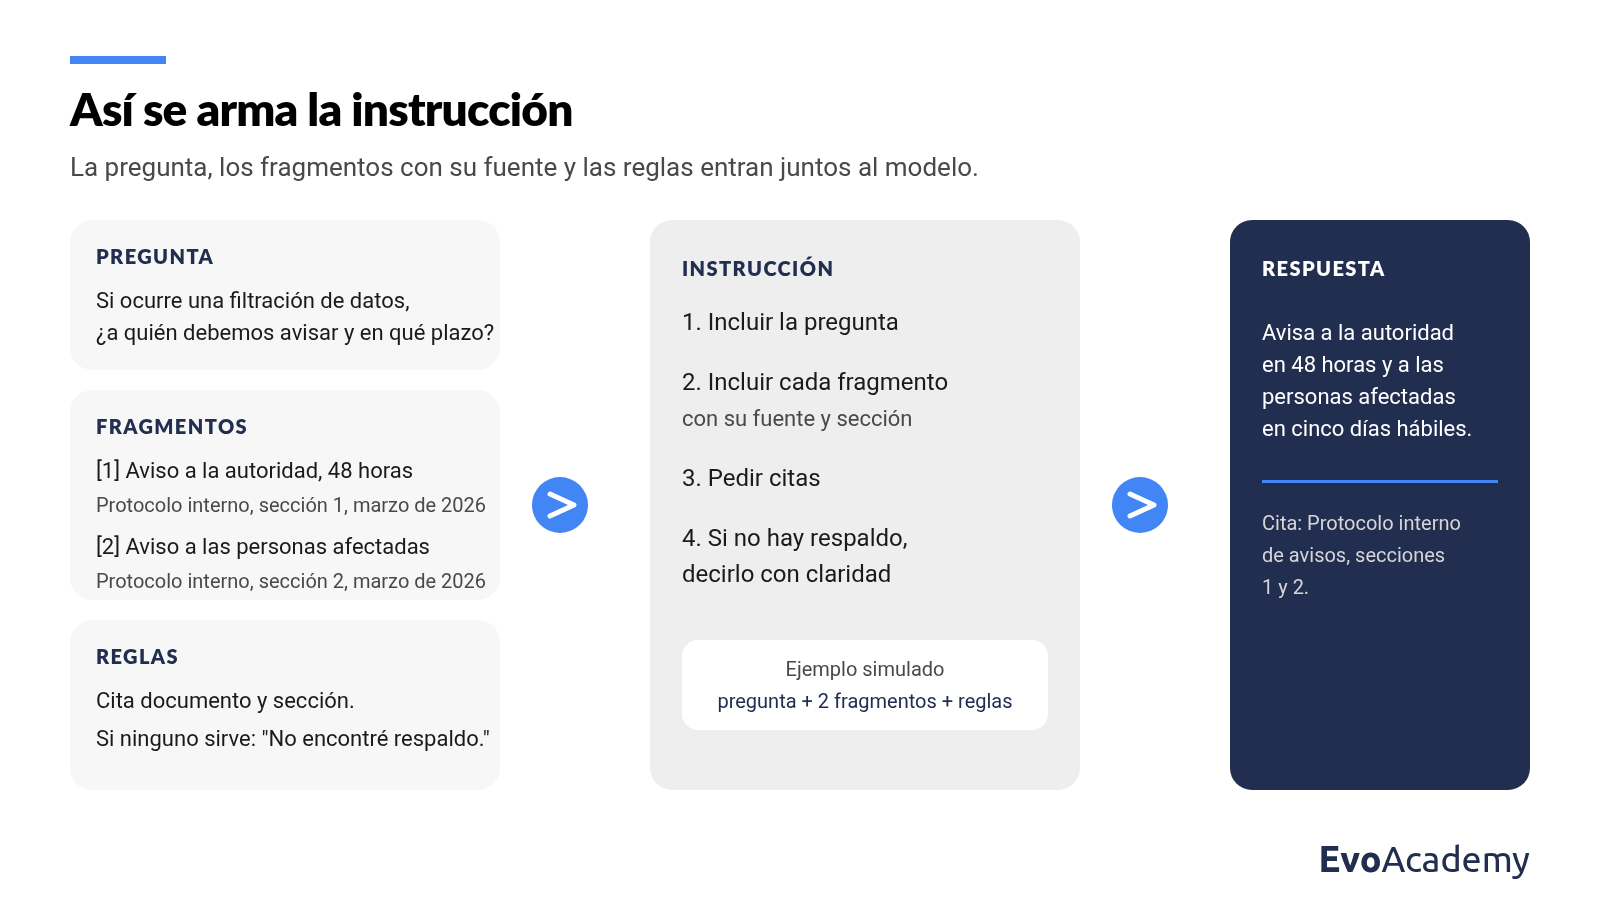
Con esa instrucción, el modelo puede responder así: si ocurre una filtración de datos, hay que avisar a la autoridad dentro de 48 horas. Ese aviso le toca al responsable de protección de datos (Protocolo interno de avisos, sección “Aviso a la autoridad”). También hay que avisar a las personas afectadas dentro de cinco días hábiles. Ese aviso le toca al equipo de atención (sección “Aviso a las personas afectadas”). Si la recuperación entrega solo una de las dos secciones, falta respaldo para el otro aviso. El modelo podría omitirlo o rellenar el vacío con información inventada; por eso vale la pena revisar la respuesta y sus citas. Otro riesgo es que la búsqueda traiga una versión desactualizada del protocolo. En ese caso, la respuesta sale equivocada. La fecha guardada como metadato ayuda a detectarlo. Volver a indexar cuando el documento cambia ayuda a evitarlo.
Variantes de RAG: Graph RAG y Agentic RAG
Cuando el fragmento más cercano no basta, dos variantes cambian la forma de recuperar.
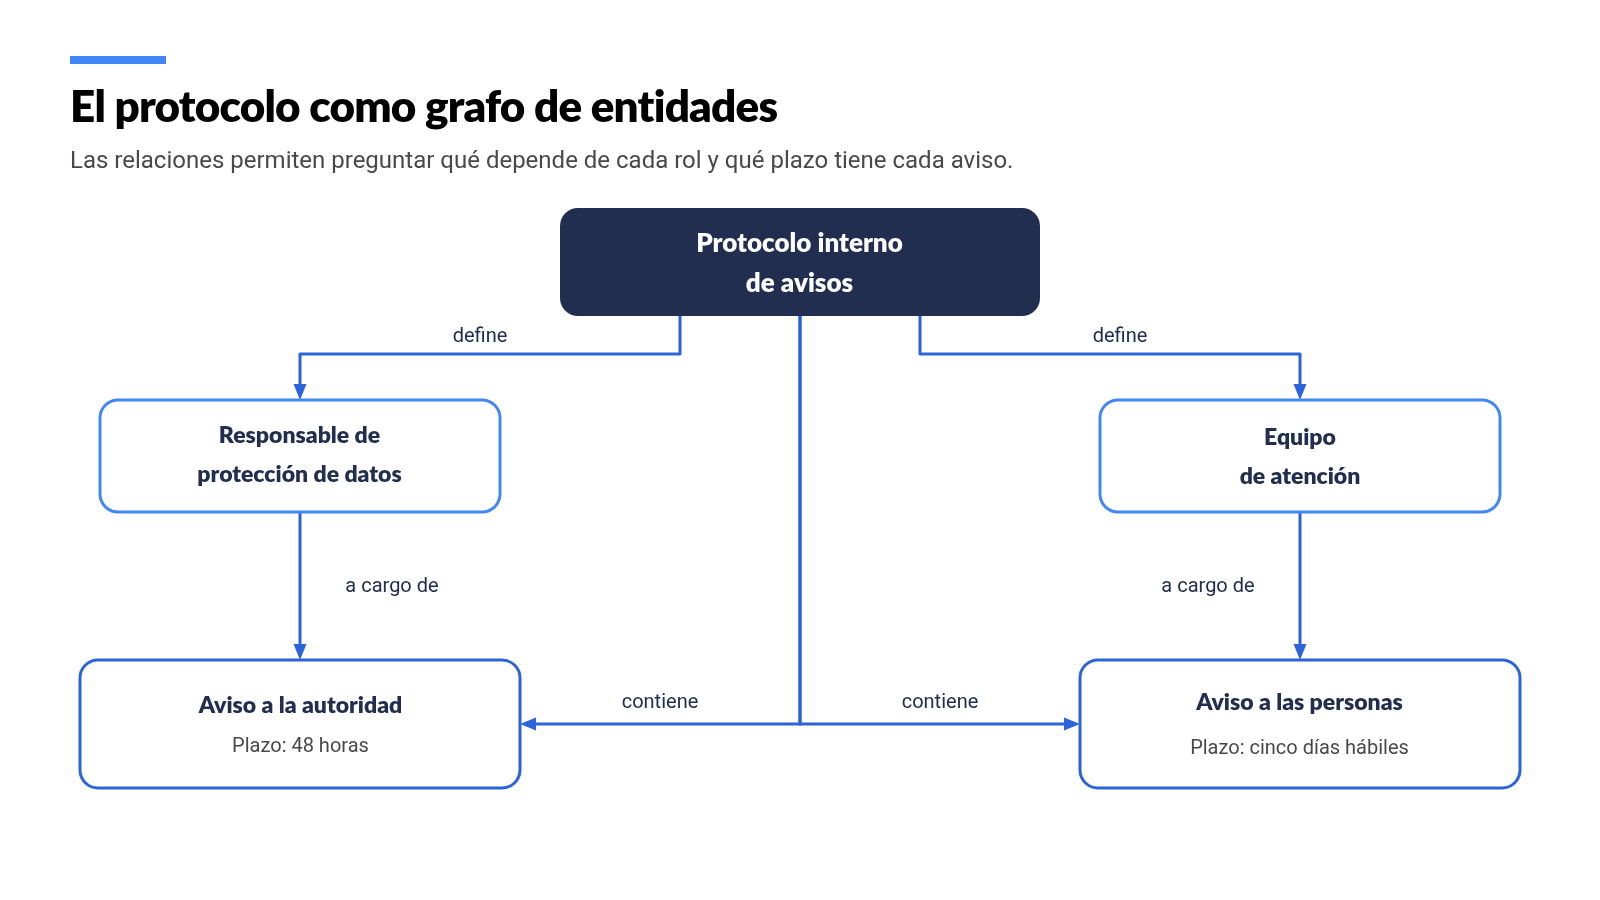
Graph RAG, además de los fragmentos, arma un mapa de entidades (personas, áreas, documentos, plazos) y de las relaciones entre ellas. Por ejemplo, suele ser útil para preguntar qué protocolos dependen de un rol que aparece con nombres distintos, como “responsable de protección de datos” en uno y “encargado de privacidad” en otro. Antes de unir esas menciones en una sola entidad, hay que comprobar que de verdad sean el mismo rol. También ayuda cuando la pregunta pide un listado que cruza varios documentos. El costo está en armar ese mapa y mantenerlo cuando los documentos cambian.
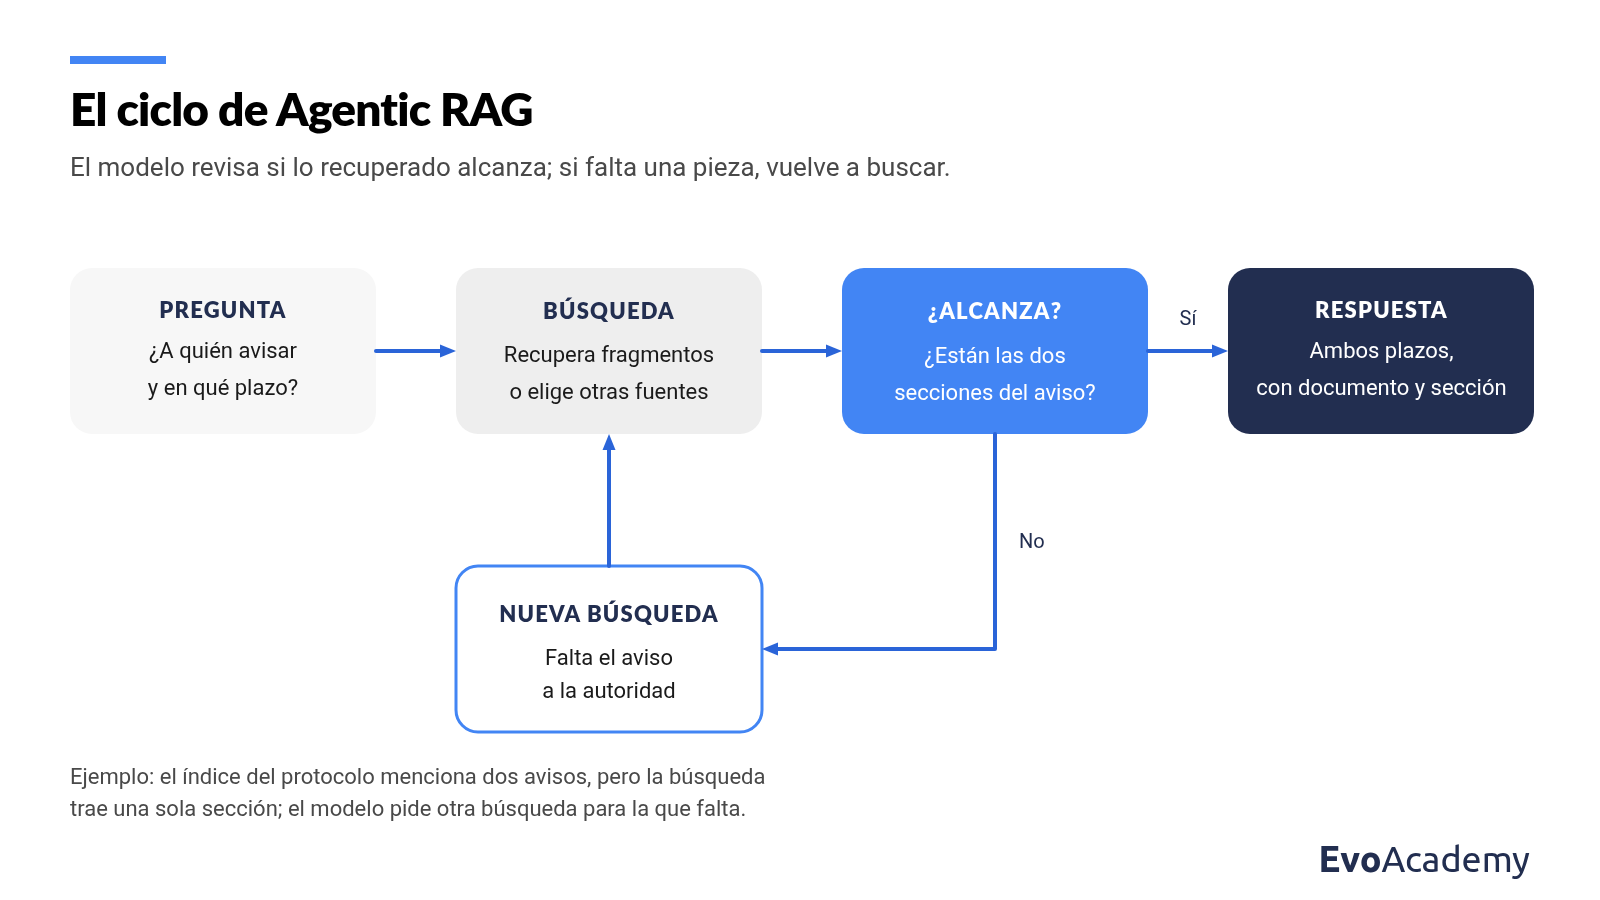
Agentic RAG, por su parte, deja que el modelo decida cómo buscar. Una forma común de hacerlo es un ciclo: en cada vuelta, el modelo recibe la pregunta, los fragmentos recuperados y unas instrucciones que le piden revisar si esos fragmentos bastan. Si cada parte de la pregunta tiene un fragmento que la respalde, responde. Si a una parte no le corresponde ningún fragmento, o si dos fragmentos se contradicen, pide una nueva búsqueda. La aplicación la ejecuta con su buscador y le devuelve los resultados. Esa búsqueda puede usar otras palabras o apuntar solo a la pieza que falta. El ciclo tiene un tope de intentos: al llegar a él, el modelo responde con lo que tiene o dice que no encontró la información. Otros diseños planifican varias búsquedas desde el inicio.
En Quillaval Seguros, supongamos que la primera búsqueda trae el aviso a las personas afectadas y también el índice del protocolo, que menciona un segundo aviso, a la autoridad. Esa mención le sirve al modelo de pista: pide otra búsqueda, “plazo de aviso a la autoridad ante una filtración”, y con la sección recuperada responde los dos avisos. Sin esa pista, podría dar por suficiente el primer resultado.
Ese “darse cuenta” es una decisión que el modelo genera siguiendo sus instrucciones, sin certeza de por medio. Puede dar por suficiente un material incompleto o seguir buscando algo que no está en los documentos. Por eso suele convenir probarlo con preguntas cuya respuesta ya conoces. Además, cada pregunta sale más lenta y más cara, porque hay más búsquedas.
| Criterio | RAG básico | Graph RAG | Agentic RAG |
|---|---|---|---|
| Cuándo conviene | Una pregunta que un fragmento cercano puede responder | Preguntas que cruzan documentos, roles o plazos | Cuando una sola búsqueda no reúne todo lo necesario |
| Cómo recupera | Busca fragmentos por similitud o de forma híbrida | Recorre el mapa de personas, roles y documentos | El modelo reescribe, busca otra vez y elige fuentes |
| Costo | Mantener el índice de fragmentos | Armar y actualizar el grafo cuando cambian los documentos | Cada pregunta sale más lenta y cara: hay más búsquedas |
Caso ilustrativo: ¿por qué un asistente confunde dos avisos?
Un modelo sin los documentos de la empresa, ante una filtración de datos, puede contestar “72 horas” y nombrar a un Delegado de Protección de Datos. Eso puede sonar plausible porque el Reglamento General de Protección de Datos (RGPD), en su artículo 33, fija 72 horas para notificar a la autoridad y menciona al delegado como punto de contacto; un protocolo interno, en cambio, puede fijar otro plazo y otra persona a cargo. En Chile, además, la Ley 21.719 entra en vigencia el 1 de diciembre de 2026: sin los protocolos vigentes, el modelo responde con una regla genérica o antigua.
En Quillaval Seguros, ante la pregunta “Si ocurre una filtración de datos, ¿a quién debemos avisar y en qué plazo?”, el protocolo ya indexado separa el aviso a la autoridad del aviso a las personas afectadas.
Si la partición corta mal, un mismo fragmento puede juntar la sección de las personas afectadas con la última línea del aviso a la autoridad. Un buscador que se queda con ese fragmento incompleto lleva al asistente a mezclar el plazo de un aviso con el responsable del otro y a omitir las 48 horas. Si cada sección queda en su propio fragmento y el buscador entrega varios candidatos, el asistente recibe los dos avisos, separa ambos plazos y cita cada sección. Por lo tanto, si un asistente falla, revisa primero qué texto recuperó: ajustar la instrucción sirve de poco si el modelo nunca recibió la regla correcta.
¿Cómo empezar a usar RAG paso a paso?
Para una primera prueba, elige una tarea acotada y documentos autorizados, sin información sensible.
- Elige una pregunta concreta, quién la usará y la herramienta. Con pocos documentos, parte con una herramienta lista.
- Prepara las fuentes: versión vigente, un responsable y qué puede consultar cada rol.
- Configura la recuperación. Prueba el número de un protocolo y la misma duda con otras palabras.
- Define cómo responde: citas con documento y sección, un aviso cuando no hay respaldo y cómo derivar la consulta a una persona.
- Mide antes de ampliar. Diez o más preguntas con respuesta y fuente esperadas, más dos cuya respuesta no esté en los documentos. Incluye un documento parecido que no debería aparecer, como una versión antigua del protocolo: si el buscador lo trae, la recuperación tiene un problema. Revisa por separado la recuperación y la interpretación.
¿Herramienta lista o sistema propio?
Claude, ChatGPT, Gemini Notebook de Google (antes NotebookLM) y Copilot Workspaces en Microsoft 365 (antes Copilot Notebooks) incluyen funciones para subir o conectar archivos y que el asistente responda a partir de ellos. Una herramienta lista suele ser un buen punto de partida, por ejemplo para un equipo que consulta pocos documentos.
Entre esa opción y un sistema armado por tu equipo hay un nivel intermedio: servicios de RAG gestionados en la nube. El proveedor se encarga de la indexación y de la búsqueda; tú subes o conectas los documentos y llamas a una API. Hace falta algo de desarrollo, aunque menos que construir el índice, la recuperación y la generación por tu cuenta. Entre las opciones actuales están la Retrieval API y File Search de OpenAI, Agent Search de Google (antes Vertex AI Search), Amazon Bedrock Knowledge Bases y Azure AI Search. Conviene revisar dónde quedan almacenados los datos, si puedes aplicar permisos por usuario y qué tanto te ata al proveedor.
Un sistema propio suele tener sentido cuando las opciones listas o gestionadas no cubren lo que necesitas, por ejemplo reglas de acceso particulares o medir cada etapa de la recuperación. En los tres caminos, mide con diez o más preguntas de respuesta conocida antes de ampliar.
| Criterio | Herramienta lista | Servicio en la nube | Sistema propio |
|---|---|---|---|
| Para quién | Un equipo y pocos documentos | Una aplicación que llama a una API | Muchos archivos, cambios frecuentes o requisitos propios |
| Quién indexa y busca | La herramienta | El proveedor | Tu equipo |
| Desarrollo | Casi ninguno | Algo, menos que un sistema propio | Completo |
| Control | El de la herramienta | Dependencia del proveedor: datos y permisos | Tú defines índice, permisos y medición |
¿Cuándo usar RAG y cuándo basta poner todo en la instrucción?
Aun con modelos que leen contextos enormes, conviene buscar: más texto no garantiza mejores respuestas, sobre todo en el medio de un contexto largo (ver anexo); enviar todo se paga y se demora; y no todas las personas pueden ver todos los documentos. El caché de contexto, que guarda la parte repetida de la instrucción entre preguntas para no volver a procesarla, abarata lo repetido, pero no resuelve calidad ni permisos.
| Criterio | Poner todo en la instrucción | Usar RAG |
|---|---|---|
| Volumen | Pocos documentos, unas pocas páginas en total | Muchos documentos o un volumen que crece |
| Cambios | Documentos que cambian poco | Versiones que se actualizan seguido |
| Acceso | Todos pueden ver todo | Permisos distintos según quién pregunta |
| Trazabilidad | Puede citar las fuentes identificadas dentro de la instrucción | Puede citar los fragmentos recuperados con su fuente y sección |
¿RAG o fine-tuning?
El fine-tuning ajusta el modelo con ejemplos para que aprenda un formato, un tono o una tarea repetitiva, como clasificar solicitudes. RAG, en cambio, deja el modelo intacto y le entrega información al responder. Si el conocimiento cambia o debe citarse, suele convenir RAG: basta con actualizar el índice con la nueva versión del documento, sin reentrenar el modelo, que toma tiempo y datos. Si el problema es cómo responde el modelo, el fine-tuning puede ayudar; muchos sistemas combinan ambos y suele convenir partir por RAG.
¿Qué cuidados exige RAG antes de conectarlo a tus datos?
RAG encuentra fuentes que se contradicen: pueden convivir una versión antigua de un protocolo y la vigente. El asistente debe mostrar el conflicto y, luego, una persona define qué versión manda. Por eso, cuando reemplazas un protocolo, verifica que la anterior deje de aparecer.
Antes de subir archivos, revisa tratamiento y retención. Además, aplica los permisos antes de buscar y comprueba que quien no está autorizado no reciba información restringida, ni en la respuesta ni en las citas. Consultar documentos no da facultades para actuar. Por eso, en decisiones sensibles, mantén la revisión humana.
Si quieres cotizar
Enseñamos a construir sistemas RAG en el curso de Fundamentos de las aplicaciones IA con LLM. En el curso, los participantes practican la partición en fragmentos (chunking), la indexación en bases vectoriales y el re-ranking con LangChain, y evalúan sus soluciones con LangSmith; también se cubre fine-tuning. Además, puedes ver una implementación sencilla con código en una clase de octubre de 2024; las herramientas y los ejemplos corresponden a esa fecha.
En EvoConsulting construimos sistemas que usan RAG, con asistentes conectados a los documentos y sistemas de tu empresa.
Si lideras un área de negocio, cuéntanos qué sabe tu equipo y qué documentos necesita consultar y adaptamos el trabajo al contexto de tu empresa.
Anexo: referencias
- Patrick Lewis y colaboradores, “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, arXiv, 2020, y NeurIPS 2020. El trabajo que dio nombre a RAG.
- Nelson F. Liu y colaboradores, “Lost in the Middle: How Language Models Use Long Contexts”, arXiv, 2023.
- Biblioteca del Congreso Nacional de Chile, Ley 21.719, regula la protección y el tratamiento de los datos personales y crea la Agencia de Protección de Datos Personales. Vigencia en su artículo primero transitorio.
- Reglamento (UE) 2016/679, Reglamento general de protección de datos, artículo 33.
- OpenAI, Retrieval y File search. Documentación de su búsqueda gestionada sobre archivos.
- Google Cloud, Agent Search (antes Vertex AI Search).
- Amazon Web Services, Amazon Bedrock Knowledge Bases.
- Microsoft, RAG and Generative AI en Azure AI Search.
- Darren Edge, Ha Trinh y colaboradores, “From Local to Global: A Graph RAG Approach to Query-Focused Summarization”, arXiv, 2024 (versión de febrero de 2025).
- Aditi Singh, Abul Ehtesham, Saket Kumar, Tala Talaei Khoei y Athanasios V. Vasilakos, “Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG”, arXiv, 2025 (versión de abril de 2026).
Preguntas frecuentes
¿Qué significa RAG?
RAG significa Retrieval-Augmented Generation, en español generación aumentada por recuperación. Cuando evalúes una solución presentada como RAG, pide ver qué fuentes consulta y cómo cita cada respuesta.
¿Cómo funciona RAG en IA?
RAG busca en tus documentos los fragmentos relevantes y se los entrega al modelo para que responda con ellos. Si una respuesta falla, revisa primero qué fragmentos recuperó.
¿RAG es una base de datos?
No. RAG es una técnica que usa una base de datos durante la recuperación. Así, tener una base vectorial es solo el comienzo: la calidad depende de cómo partes los documentos, cómo buscas y cómo mides.
¿Un sistema RAG es un modelo de IA?
No. Un sistema RAG combina un buscador con un modelo generador y se evalúa completo: cambiar de modelo no corrige un problema que nace en la lectura del PDF o en una versión desactualizada.
¿Cuál es un ejemplo de RAG?
Un ejemplo es un asistente que, ante una filtración de datos, consulta el protocolo interno de la empresa, entrega los plazos y los responsables que ahí figuran y cita el documento y la sección. Sin esos documentos, el modelo puede responder con una regla genérica, como un plazo de otra normativa.
¿Hay que reentrenar el modelo para usar RAG?
No. RAG le entrega los documentos al modelo en el momento de preguntar, sin reentrenarlo. Si lo que necesitas es conocimiento nuevo o actualizado, parte por RAG antes de considerar un ajuste del modelo.
¿Cuál es la diferencia entre RAG y fine-tuning?
RAG deja el modelo intacto y le entrega información al responder; el fine-tuning lo ajusta con ejemplos para que aprenda un formato, un tono o una tarea repetitiva. Usa RAG cuando el conocimiento cambia o debe citarse; reserva el fine-tuning para cómo responde el modelo, y combina ambos solo si cada uno cubre un problema distinto.
¿Se puede usar RAG con ChatGPT?
Sí. ChatGPT incluye funciones para subir o conectar archivos y que el asistente responda a partir de ellos. Esa vía suele servir para una primera prueba con pocos documentos. Por ejemplo, si necesitas reglas de acceso que la herramienta no admite, puedes evaluar un servicio gestionado o un sistema propio.
¿LangChain es lo mismo que RAG?
No. RAG es la técnica de buscar fragmentos y entregárselos al modelo; LangChain es una biblioteca con la que se puede armar ese flujo, desde la partición hasta la recuperación. Puedes implementar RAG con LangChain o con otras herramientas.
¿Un sistema RAG es un agente de IA?
No necesariamente. Un sistema RAG recupera fragmentos y se los entrega a un modelo para que responda con ellos. Un agente puede, además, decidir pasos, usar herramientas y encadenar acciones; algunos agentes usan RAG como una de esas herramientas, y en Agentic RAG el propio modelo decide cómo buscar y si lo recuperado alcanza.
¿Qué es Graph RAG?
Graph RAG suma al índice de fragmentos un mapa de quiénes y qué se relacionan en los documentos: personas, áreas, plazos y los vínculos entre ellos. Por ejemplo, suele convenir más que el RAG básico cuando el mismo rol se nombre de un modo distinto en otros documentos.
¿Qué es Agentic RAG?
Agentic RAG deja que el modelo decida cómo buscar. En un diseño por ciclos, el modelo recibe los fragmentos recuperados junto con instrucciones para revisar si alcanzan. Si considera que falta respaldo o que dos fragmentos se contradicen, pide otra búsqueda; la aplicación la ejecuta y le devuelve los resultados, hasta un tope de intentos. Por ejemplo, si una búsqueda trae el aviso a las personas afectadas y un índice que menciona otro aviso a la autoridad, el modelo puede pedir una búsqueda para recuperar esa sección. Esa revisión es un juicio del modelo y puede fallar, y cada pregunta toma más tiempo. Ese ciclo de búsqueda y revisión es el rasgo más común de esta variante.
Escúchalo en el podcast
En EvoAcademy publicamos un podcast semanal sobre IA aplicada a los negocios. Este episodio explica los fundamentos de RAG.
- #44 RAG: cómo personalizar la IA con tus documentos
Episodio de febrero de 2024: las herramientas que menciona corresponden a esa fecha.
Cursos relacionados
-
Fundamentos de las aplicaciones IA con LLM
Entiende cómo funcionan los LLM y crea aplicaciones de IA generativa con técnicas como RAG y fine-tuning.
Cotiza tu curso
Cuéntanos qué necesita tu equipo y te enviamos una propuesta para un curso a la medida de tu empresa.